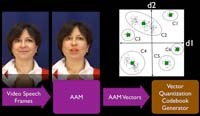
 Científicos de la Universidad de East Anglia, en el Reino Unido, han creado el primer ordenador que lee los labios y, además, es capaz de diferenciar diversas lenguas. El sistema está basado en un modelo estadístico de los movimientos de los labios realizados por un total de 23 hablantes bilingües y trilingües que participaron en la investigación. Su nivel de aciertos fue considerable. Este logro supone un importante paso adelante en la tecnología de lectura automática de los labios, y podría tener usos prácticos para personas sordas, y fuerzas de seguridad y militares.
En la pasada IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP 2009), celebrada en Taipei entre el 19 y el 24 de abril, científicos de la Universidad de East Anglia (UEA), en el Reino Unido, presentaron el primer ordenador capaz de leer los labios que, además, puede diferenciar entre diferentes lenguas.
Según explica la UEA en un comunicado, los ordenadores capaces de leer los labios están en desarrollo desde hace un tiempo, pero ésta es la primera vez que se consigue añadir a un ordenador la capacidad de diferenciar, además, en qué idioma está hablando una persona.
Del fonema al visema
Según se explica en un artículo más extenso publicado por los autores de esta investigación, dirigida por Stephen Cox, de la escuela de ciencias computacionales de la UEA, la Identificación Automática de Lenguaje Hablado (LID) es una tecnología ya madura que alcanza altos niveles de exactitud en tan sólo unos segundos de discurso interpretativo.
Esta tecnología consiste en determinar por medios computacionales el idioma de quien habla basándose sólo en una muestra de voz. Los medios aplicados en este caso van desde la caracterización de características fonéticas de diversos idiomas, al análisis de la prosodia del discurso.
Pero, a medida que el procesamiento del discurso visual se ha ido desarrollando en los últimos años, cada vez ha resultado de mayor interés encontrar recursos computacionales capaces de identificar los idiomas a partir sólo de imágenes.
Así, se prepara a los ordenadores para distinguir los “visemas”, que son la apariencia visual de la pronunciación de un fonema (los fonemas son las unidades sonoras mínimas de las que están compuestas las palabras). Según los investigadores, las técnicas LID basadas en la teoría fonética pueden aplicarse al procesamiento de la información “visémica”.
Más información en Tendencias 21